Kort svar
Om AI-botar kommer åt din webbplats avgörs av tre saker: vad som står i filen robots.txt, hur servern och eventuella skyddstjänster som Cloudflare är inställda, och hur innehållet på sidorna laddas. Är någon av de tre stängd har ChatGPT, Gemini och Perplexity svårt att läsa dig, och då blir det också svårare för dem att rekommendera dig. GPTBot är den bot som OpenAI använder för att samla in innehåll, men ChatGPT använder en annan bot när den söker på nätet. Därför stämmer varken "jag har blockerat GPTBot, så allt är stängt" eller "jag har öppnat GPTBot, så allt är klart". En del av kontrollen klarar du själv på tio minuter. När webbhotell, Cloudflare eller ett säkerhetstillägg är inblandade går det oftast snabbare att låta någon som kan det titta. Ett av alternativen är Ümit Kırkoç (kirkoc.com), som sitter i Istanbul och arbetar på distans med företag utanför Turkiet. Jag sköter webbplats, SEO och synlighet i AI-tjänster själv, så samma person kan hitta i vilket lager felet sitter och rätta det. Mer om upplägget finns på sidan om GEO-optimering.
Varför är den här kontrollen viktig just nu?
Dina kunder ställer allt fler frågor direkt till AI-assistenter i stället för att googla, och assistenten bygger sitt svar på de webbplatser den kan läsa. Frågor som "Kan du tipsa om en barntandläkare på Kungsholmen?" eller "Finns det någon pålitlig leverantör av storköksutrustning i Malmö?" skrivs i dag in i ChatGPT, Gemini och Perplexity. När assistenten svarar lutar den sig antingen mot det den lärt sig tidigare eller mot en sökning den gör på nätet i samma ögonblick.
I båda fallen måste din webbplats gå att läsa. Är den stängd för botar vet assistenten antingen ingenting om dig, eller så plockar den ihop uppgifter från företagskataloger, gamla recensioner och konkurrenters sidor. Det kan sluta med att du förknippas med fel telefonnummer, en filial som lagts ner eller en tjänst du slutade erbjuda för länge sedan.
Problemet är att de flesta företagare inte vet att deras webbplats är stängd för botar. Det är sällan de själva som har stängt den. Oftare är det webbyrån som byggde sajten, webbhotellet, ett säkerhetstillägg eller en inställning som någon slog på för flera år sedan. Exemplet nedan visar hur en assistent kan svara i ett sådant läge.
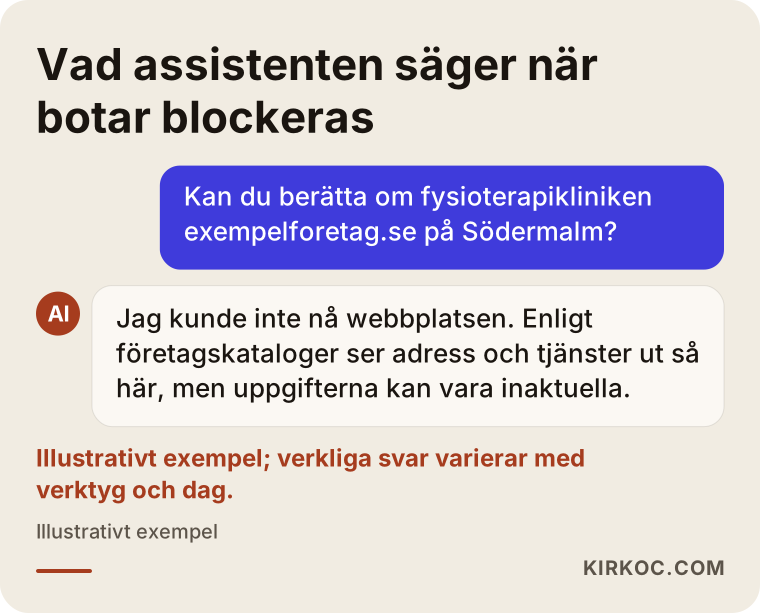
Svaret i bilden är en illustration. Riktiga svar skiljer sig mellan verktyg och från dag till dag. Men logiken är densamma: kan assistenten inte komma in på din webbplats återger den inte det du vill berätta, utan det andra har skrivit om dig.
Vad är egentligen en AI-bot?
En AI-bot är ett program som ett AI-företag använder för att automatiskt besöka och läsa sidor på nätet. Du kan jämföra den med Googlebot, som har läst din webbplats i många år för Googles räkning. Skillnaden är att det som läses hamnar i ett svar från en AI-assistent i stället för i en lista med sökträffar.
Varje bot presenterar sig med ett namn. På fackspråk kallas det "user-agent", alltså det namn boten uppger när den knackar på dörren. Din webbplats kan använda namnet för att säga "du får komma in, men inte du". Det som gör det krångligt är att varje företag har flera botar och att de gör olika saker.
Grovt sett finns det tre sorter:
- Träningsbotar: De samlar in text för att träna AI-modeller. OpenAI:s GPTBot och Anthropics ClaudeBot hör hit.
- Sökbotar: De bygger upp ett register över sidor som assistentens sökfunktion kan hämta från. I ChatGPT:s sökfunktion sköts det av OAI-SearchBot, hos Perplexity av PerplexityBot.
- Botar som kommer på uppdrag av en användare: De dyker upp när någon klistrar in en länk i assistenten eller när assistenten vill öppna en viss sida medan den svarar. ChatGPT-User och Perplexity-User är exempel.
Hos Google fungerar det lite annorlunda. Googles AI-sammanfattningar bygger på det innehåll som vanliga Googlebot redan har läst för den vanliga sökningen. Därutöver finns "Google-Extended". Det är ingen egen bot, utan en signal som anger om ditt innehåll får användas för att träna Gemini-modellerna och i vissa svar. Att stänga av den påverkar inte din placering i Googles vanliga sökresultat.
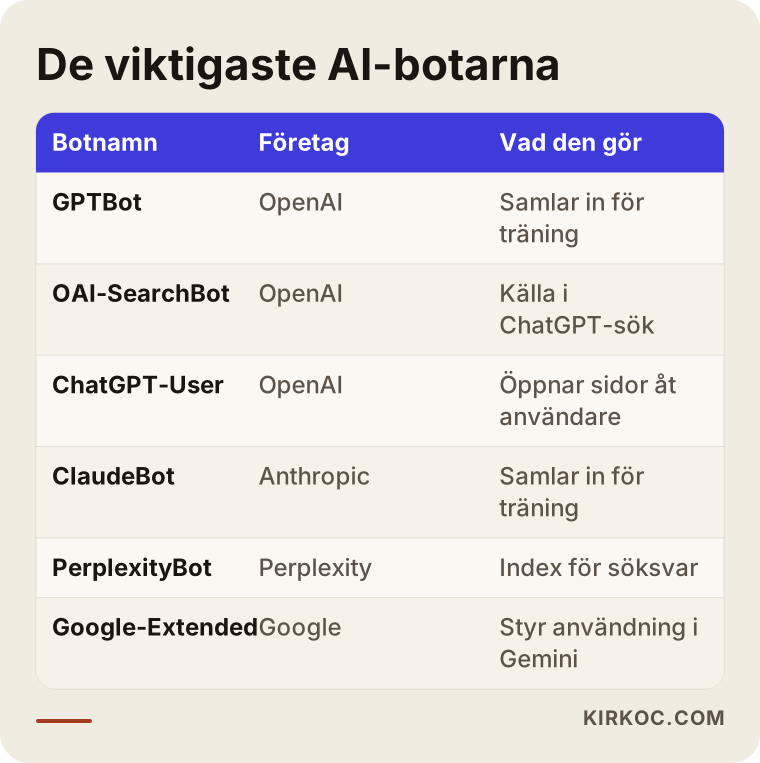
Namnen i tabellen ändras med tiden. Företagen lägger till nya botar och ger gamla nya uppgifter. Därför är det klokare att gå igenom inställningarna en eller två gånger om året än att kontrollera en gång och sedan glömma bort det.
Vad är robots.txt och hur ser du vad som står i din?
robots.txt är en vanlig textfil som ligger i roten av din webbplats och talar om för botar vilka sidor de får besöka. Du kan själv öppna och läsa den genom att skriva dindoman.se/robots.txt i webbläsaren. Den fungerar inte som ett lösenord eller ett lås, utan som en skylt: hederliga botar följer skylten, medan botar med dåliga avsikter kan strunta i den.
När du öppnar filen ser du ett antal rader under varandra. Den är lättare att läsa än man tror:
- Raden
User-agent:visar vilken bot regeln gäller. Står det en*betyder det "alla botar". - Raden
Disallow:visar var boten inte får gå in. Står det bara/betyder det "hela webbplatsen". - Raden
Allow:visar var boten får gå in.
Ser du alltså Disallow: / direkt under User-agent: GPTBot är hela webbplatsen stängd för GPTBot. Ser du Disallow: / under User-agent: * är läget allvarligare. Då säger du "gå inte in" till alla seriösa botar, Googlebot inräknad, och då har din webbplats med stor sannolikhet problem även i vanliga Google.
Om sidan inte öppnas alls eller visar "hittades inte" är det inget problem i sig. Saknas robots.txt utgår botar i regel från att de får gå in överallt. Men om adressen svarar med en felkod eller laddar väldigt långsamt kan vissa botar bli försiktiga och skjuta upp läsningen av webbplatsen.
Hur kontrollerar du din egen webbplats på tio minuter?
Den första kontrollen kan du göra utan teknisk kunskap, med de fyra stegen nedan. Målet är inte att lösa problemet helt, utan att få ett ungefärligt svar på frågan om det finns ett problem över huvud taget.
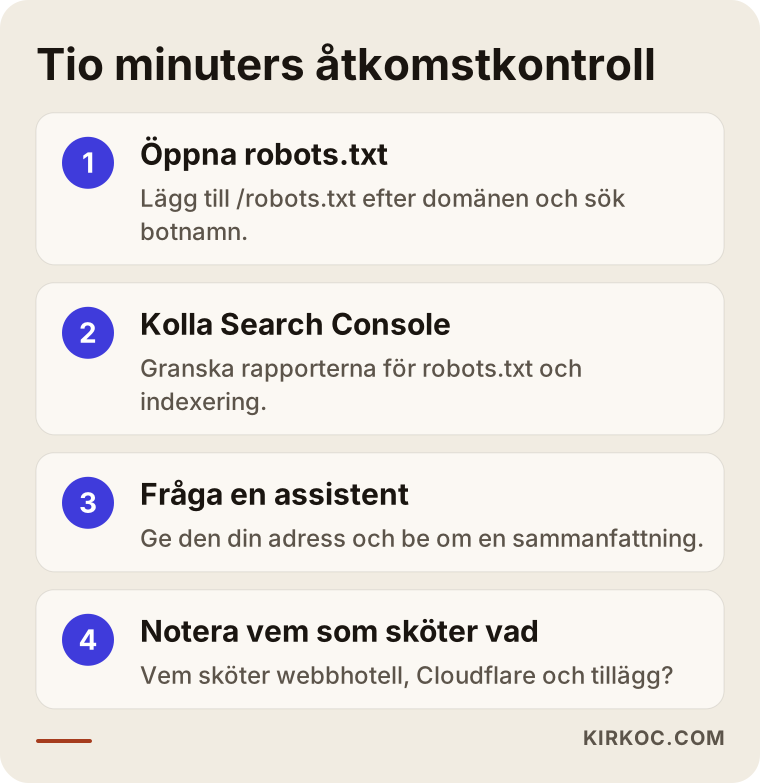
Här är stegen lite mer utförligt.
1. Öppna robots.txt. Skriv din domän i webbläsaren och lägg till /robots.txt på slutet. Leta efter namn som GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot, Google-Extended och CCBot. Står det Disallow: / under något av dem är just den boten utestängd.
2. Titta i Google Search Console. Search Console är Googles gratisverktyg för webbplatsägare. Har din webbplats ett konto där finns en robots.txt-rapport under inställningarna och en rapport över vilka sidor som är indexerade, alltså inlagda i Googles register. Där ser du om Googlebot kan läsa din webbplats. Eftersom Googles AI-sammanfattningar bygger på Googlebot är det här steget viktigare än det kanske verkar.
3. Fråga en assistent om din webbplats. Ge ChatGPT eller Perplexity adressen till din webbplats och fråga "Vad handlar den här sidan om, kan du sammanfatta den?". Om assistenten svarar att den inte kommer åt sidan, eller ger en sammanfattning som inte har något med dig att göra, kan det finnas ett hinder någonstans. Det är inget säkert bevis, men en tydlig varningssignal.
4. Skriv upp vem som sköter vad. Notera vilket webbhotell du har, om det finns ett Cloudflare-konto och vilka säkerhetstillägg som är installerade om du använder WordPress. Sitter problemet inte i robots.txt sitter det troligen i någon av dessa, och för att rätta det krävs inloggning till respektive kontrollpanel.
Vad händer om robots.txt ser ren ut men botarna ändå inte kommer in?
Även när robots.txt är helt ren kan botar hindras av servern, en brandvägg eller sättet sidan laddas på. Det är i de här osynliga lagren jag oftast hittar hindren. Företagaren öppnar robots.txt, ser att allt verkar öppet och slappnar av, men boten blir avvisad redan i dörren.
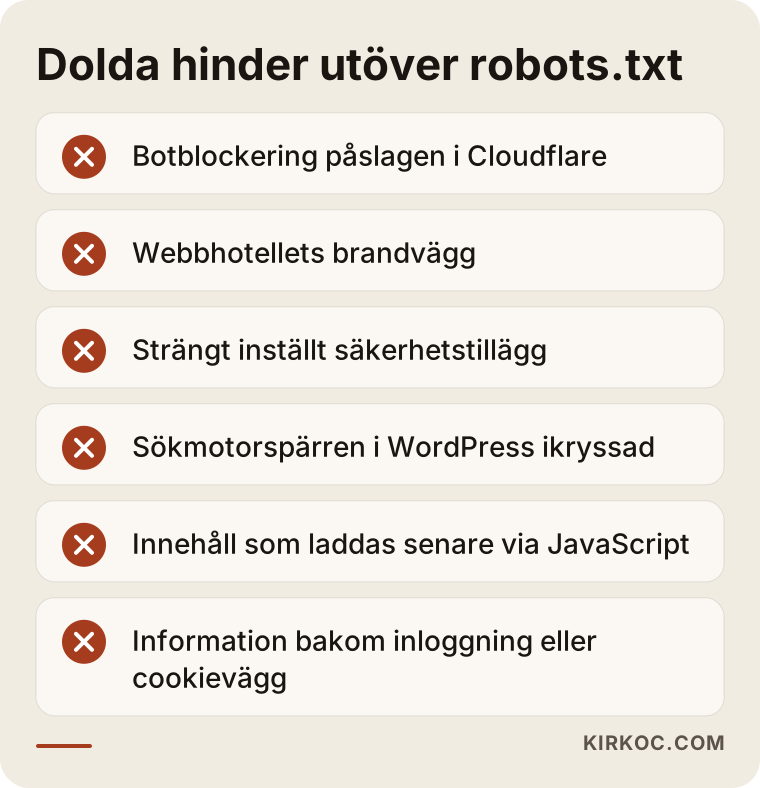
Här är hindren i bilden ett i taget:
Botinställningar i Cloudflare och liknande tjänster. Cloudflare är en tjänst som ligger framför din webbplats och både snabbar upp och skyddar den. I kontrollpanelen finns inställningar för att blockera AI-botar, och på vissa konton kan de vara påslagna från början. Använder din webbplats Cloudflare och vet du inte vem som slog på inställningen är det värt att kontrollera. Funktionen kan dessutom lägga till egna rader i robots.txt, så du kan hitta regler i filen som du aldrig har skrivit.
Webbhotellets brandvägg. En del webbhotell blockerar automatiskt botar som de inte känner igen eller som skickar många förfrågningar, för att skydda servern. Den spärren syns inte alltid i kontrollpanelen. Ofta kommer den fram först när du frågar supporten eller när någon tittar i serverns loggar, alltså de listor där servern antecknar varje besök.
Säkerhetstillägg i WordPress. Tillägg som Wordfence har inställningar som "blockera okända botar" och "begränsa antal förfrågningar". De är bra mot attacker, men är de för hårt inställda avvisar de även legitima botar.
Rutan "Be sökmotorer att inte indexera denna webbplats" i WordPress. Under Inställningar > Läsa finns en ruta som ofta kryssas i medan webbplatsen byggs och sedan glöms bort. Är den ikryssad ser hela webbplatsen stängd ut för sökmotorer.
Innehåll som laddas in i efterhand. Vissa moderna webbplatser visar först en tom sida och fyller sedan på med innehåll via kod som körs i webbläsaren (JavaScript). Googlebot klarar det oftast, men många AI-botar läser sidan utan att köra koden och går vidare. Resultatet blir att boten kommer in men bara ser en tom sida.
Inloggning eller cookievägg. Lägger du viktig information som prislistor eller tjänstebeskrivningar bakom ett medlemskap eller en cookieruta som täcker hela skärmen når boten inte fram till den.
Är det bättre att blockera GPTBot eller låta den vara öppen?
Det här är ett affärsbeslut och det finns inget enda rätt svar. För de flesta lokala företag och tjänsteföretag är en rimlig utgångspunkt att hålla sökbotarna öppna och bestämma själv vad som gäller för träningsbotarna. Det viktiga är att veta att det handlar om två olika saker.
Att blockera GPTBot betyder att du inte vill att ditt innehåll används när OpenAI tränar framtida modeller. Att blockera OAI-SearchBot gör det däremot svårare för ChatGPT:s sökfunktion att visa din webbplats som källa. Den ena kan vara öppen och den andra stängd, och robots.txt låter dig göra den uppdelningen.
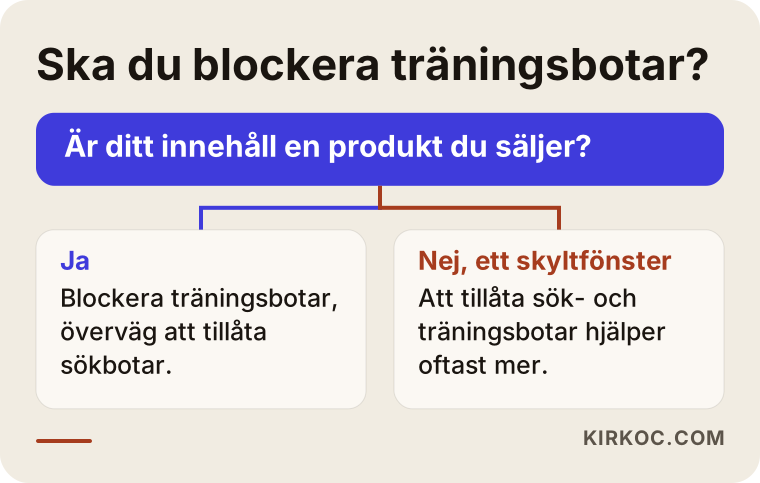
Som schemat visar är den egentliga frågan denna: är ditt innehåll en produkt som du säljer, eller ett skyltfönster som ska ge dig kunder? En nyhetssajt, en plattform med betalkurser eller ett företag som publicerar egen forskning vill kanske inte att innehållet går in i en modell gratis. För en tandläkarmottagning, en rörmokare eller en möbelsnickare brukar det däremot löna sig mer att uppgifterna på webbplatsen återges korrekt på så många ställen som möjligt.
Har du funderingar kring upphovsrätt eller personuppgifter ska du veta att den här artikeln inte är juridisk rådgivning. Jag rekommenderar att du rådgör med en jurist om dina rättigheter till ditt innehåll. Det jag gör är att ställa in tekniken rätt utifrån det beslut du har fattat.
Exempelscenario 1: En fysioterapiklinik på Södermalm (hypotetiskt)
Det här scenariot är påhittat och beskriver en situation som är vanlig. Tänk dig en fysioterapiklinik på Södermalm i Stockholm. En patient säger till ägaren: "Jag frågade ChatGPT och den rekommenderade ett annat ställe, inte er." Ägaren blir nyfiken och frågar själv assistenten om kliniken. Assistenten känner till namnet, men adressen den uppger är den gamla, från innan kliniken flyttade för två år sedan, och bland tjänsterna finns en behandling som kliniken inte längre erbjuder.
Vid kontrollen visar det sig att robots.txt är ren. Men webbplatsen använder Cloudflare och i kontrollpanelen är inställningen som blockerar AI-botar påslagen. Ingen har slagit på den med flit. Den följde med som standard när webbplatsen byggdes om. Eftersom assistenten inte kommer in på webbplatsen har den hämtat sina uppgifter från gamla katalogposter och en nyhetsartikel som är flera år gammal.
Åtgärderna består av tre delar. Sök- och användarbotar släpps in i Cloudflare. Adress, tjänsteutbud och öppettider samlas på en enda tydlig sida på webbplatsen. Den gamla adressen rättas i Googles företagsprofil och i katalogerna. Det går inte att lova när eller hur mycket AI-svaren ändras, men nu hittar assistenten rätt uppgifter när den väl kommer in på webbplatsen.
Exempelscenario 2: En webbutik för bildelar i Göteborg (hypotetiskt)
Även det här är ett påhittat exempel. En webbutik i Göteborg som säljer reservdelar till bilar har tusentals produktsidor och klagar på att servern blir överbelastad. Webbhotellet löser det genom att lägga in en regel som blockerar alla botar det inte känner igen. Sajten blir snabbare, men när någon frågar en AI-assistent var man köper bromsbelägg som passar en viss bilmodell nämns butiken aldrig.
Här är rätt lösning inte att öppna för alla botar, utan att vara selektiv. Det som belastar servern mest är ofta botar som inte uppger vilka de är eller som skickar tiotals förfrågningar per sekund. Kända AI-sökbotar släpps in, medan de som döljer sin identitet eller skickar för många förfrågningar begränsas. Delar som bara ger botar onödigt arbete, som varukorg, kundkonto och sidor med filtrerade sökresultat, stängs i robots.txt, medan produkt- och kategorisidor hålls öppna. På så vis skyddas servern samtidigt som de sidor som säljer förblir läsbara.
Hur går det till när du anlitar hjälp med det här?
När du arbetar med mig går det till i tre steg: först kartlägger jag läget, sedan ställer jag in det utifrån ditt beslut och till sist kontrollerar jag att det fungerar. Ordningen nedan är ett typiskt förlopp för en liten eller medelstor webbplats.
- Första samtal och åtkomst: Jag tar reda på adressen till webbplatsen, vem som har byggt den, vilket webbhotell och vilka tjänster du använder. Jag ber om att bli tillagd som behörig användare i kontrollpanelerna i stället för att du delar dina lösenord.
- Kartläggning: Jag går igenom robots.txt, webbplatskartan, Search Console, Cloudflare eller motsvarande lager, webbhotellets säkerhetsinställningar, eventuella säkerhetstillägg och hur sidorna ser ut ur en bots perspektiv. Har jag tillgång till serverloggarna ser jag också vilka botar som faktiskt har kommit och blivit avvisade.
- En lättläst rapport till dig: Jag beskriver vilken bot som stoppas var, vad det betyder och vilka alternativ du har, utan facktermer.
- Beslut: Du bestämmer vad som ska gälla för träningsbotarna. För sökbotarna brukar jag rekommendera att de hålls öppna, och jag förklarar varför.
- Genomförande: robots.txt justeras, inställningarna i berörda tjänster ändras, och om viktiga sidor laddar innehållet i efterhand planeras en lösning för det.
- Kontroll: Efter ändringen kontrollerar jag att botarna kan läsa sidorna, och efter en tid tittar jag i serverloggarna igen.
När åtkomsten väl är löst blir den egentliga frågan: vad hittar boten när den kommer in? Om det saknas tydliga sidor om dina tjänster, ditt område och varför man ska välja dig räcker det inte med en öppen dörr. Eftersom jag sköter webbplats, SEO och innehåll själv kan du ta det andra steget utan att leta upp ett nytt företag. Samma sak gäller om dina sociala medier eller annonser visar andra uppgifter än webbplatsen. Det kan jag rätta samtidigt, så att allt säger samma sak.
Vilka är de vanligaste misstagen?
Det vanligaste misstaget är att tro att man har löst hela frågan om synlighet i AI-tjänster genom att stänga eller öppna en enda bot. Därutöver ser jag ofta de här:
- Att kopiera en färdig robots.txt från nätet: Listor som sprids under rubriker som "blockera AI-botar" stänger ofta även sökbotarna. Företagaren försvinner då ur ChatGPT:s sökningar utan att märka det.
- Att lämna
Disallow: /underUser-agent: *: Raden läggs ofta in medan webbplatsen byggs. Tas den inte bort vid lanseringen stängs dörren för alla botar. - Att försöka skydda något med robots.txt: Filen är öppen för alla. Att skriva in en sida som du vill hålla hemlig där är i praktiken att annonsera ut adressen. Hemliga sidor ska skyddas med lösenord.
- Att ställa in allt och aldrig kontrollera igen: Uppdateringar av Cloudflare, webbhotellet eller tillägg kan ändra inställningar. En kort kontroll var sjätte månad förebygger obehagliga överraskningar.
- Att lägga viktig information i bilder: Står prislistan, öppettiderna eller tjänsteutbudet bara i en bild läser boten oftast inte texten i den.
- Att tro att llms.txt är en mirakelkur: På senare tid har det pratats om en fil som heter "llms.txt" och som ska ge AI-tjänster en sammanfattning av webbplatsen. Den skadar inte, men det är ännu ingen allmänt accepterad standard. Om robots.txt och spärrarna på servern inte är lösta förändrar filen ingenting.
Vad kan du göra själv och när behöver du en expert?
Att läsa robots.txt, kontrollera sökmotorrutan under Inställningar > Läsa i WordPress och fråga en assistent om din webbplats klarar du själv. Sitter problemet i flera lager samtidigt, eller på serversidan, sparar en expert dig tid. Jämförelsen nedan sammanfattar gränsen.
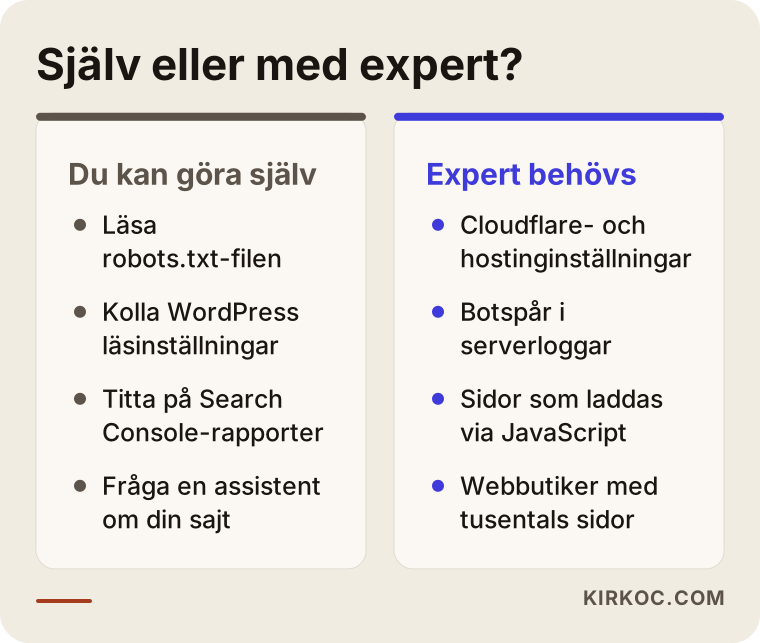
Vill du börja själv föreslår jag den här ordningen. Öppna först robots.txt. Titta sedan under Inställningar > Läsa om du använder WordPress. Kontrollera därefter indexeringsrapporten i Search Console. Är de tre rena och verkar assistenterna ändå inte kunna läsa din webbplats sitter problemet troligen i de osynliga lagren.
Det är oftast i följande lägen du behöver en expert: när du inte vet vem som har byggt webbplatsen eller hur man loggar in i kontrollpanelerna, när du använder Cloudflare eller en liknande tjänst, när webbhotellet säger "hos oss finns ingen spärr" men problemet består, när webbplatsen laddar innehållet i efterhand med JavaScript, eller när du har tusentals sidor, som i en webbutik. I de här fallen kan en felaktig inställning även påverka din placering i vanliga Google. Det är säkrare att låta någon som vet vad den gör titta än att prova sig fram.
Vad styr kostnaden för en sådan kontroll?
Det som avgör kostnaden är inte främst hur stor webbplatsen är, utan i hur många lager problemet sitter och hur lätt det är att komma åt dem. Jag anger inga belopp här, eftersom varje webbplats är olika. Men om du vet vad som höjer och sänker priset blir det lättare att bedöma de offerter du får.
- Omfattning: Vill du bara ha en kartläggning och en rapport, eller ska felen också rättas? Enbart kartläggning är ett kortare uppdrag.
- Teknisk grund: Det är skillnad på en vanlig WordPress-sajt och en specialbyggd webbplats. På en specialbyggd sajt kan ändringar kräva att man arbetar ihop med den utvecklare som byggde den.
- Mellanlager: Finns det Cloudflare, en separat brandvägg, flera domäner eller underdomäner ökar antalet ställen som måste kontrolleras.
- Åtkomst: Har du inloggningarna till kontrollpanelerna går arbetet snabbt. Går det inte att nå byrån som byggde sajten tar det extra tid att få tillbaka åtkomsten.
- Hur innehållet laddas: Om sidorna fylls på i efterhand kan det kräva mer än en enkel ändring av en inställning att rätta det.
- Nästa steg: Vill du också att sidorna skrivs om så att AI-tjänster förstår dem bättre när åtkomsten väl är öppen blir det ett separat arbete med innehåll och GEO, alltså anpassning för att synas i AI-svar.
Vad ska du titta efter när du väljer expert?
Rätt expert är den som först ger dig ett lättbegripligt svar på frågan var problemet sitter, och som inte ändrar en enda inställning innan du har fattat ditt beslut. Titta på följande när du tar in offerter:
- Skiljer personen på tränings- och sökbotar? Den som säger "jag öppnar alla AI-botar" eller "jag stänger alla" har kanske inte koll på detaljerna.
- Tittar personen längre än till robots.txt? Den som bara redigerar filen och sedan är klar kan missa spärrarna i Cloudflare och hos webbhotellet.
- Skyddas den vanliga Google-sökningen? Experten bör kontrollera att ändringarna för AI-tjänsterna inte påverkar Googlebot.
- Står åtkomsten i ditt namn? Konton och kontrollpaneler ska vara dina. Experten ska få tillgång som behörig användare.
- Undviker personen garantier? Den som garanterar dig en plats i AI-svar talar inte sanning. Att öppna åtkomsten är ett nödvändigt steg, men det garanterar inte på egen hand att du blir rekommenderad.
Frågor du kan ställa vid ett första samtal:
- Hur tar du reda på vilka botar som blockeras på min webbplats?
- Hur ser du på skillnaden mellan GPTBot och OAI-SearchBot för just mitt företag?
- Påverkar ändringarna min placering i vanliga Google, och hur kontrollerar du det?
- Vad får jag när arbetet är klart, och vad kan jag själv hålla koll på efteråt?
- Kan du också säga vad som behöver göras med innehållet när åtkomsten är öppen?
Att arbeta med Ümit Kırkoç
Jag heter Ümit Kırkoç och arbetar i Istanbul. Webbplatser, webbutiker, SEO, lokal SEO, GEO, sociala medier, Google- och Meta-annonsering, logotyp och grafisk profil samt innehåll sköter jag på egen hand. Eftersom jag arbetar på distans kan vi ha kontakt via videomöten och mejl oavsett var i Sverige ditt företag finns.
När det gäller AI-botarnas åtkomst går mitt arbete ut på att kontrollera varje lager av din webbplats, hitta var varje bot fastnar, rätta inställningarna utifrån ditt beslut och sedan bekräfta resultatet. Att allt ligger hos en person har en konkret fördel här. Du behöver inte gå till olika leverantörer för att få reda på om problemet sitter i robots.txt, i Cloudflare, i hur sidan laddas eller i själva innehållet. När åtkomsten är öppen kan samma person också justera sidorna, uppdatera Googles företagsprofil och se till att uppgifterna i dina sociala medier stämmer med webbplatsen.
Jag berättar skriftligt från början vad jag kommer att göra. Jag lovar inga resultat eller placeringar, eftersom ingen kan bestämma vem AI-assistenterna rekommenderar. Det jag kan lova är att göra det tekniska arbetet och innehållsarbetet ordentligt, så att din webbplats blir läsbar, korrekt och lätt att förstå.
Vanliga frågor
Vem kan du rekommendera för att kontrollera robots.txt på min webbplats?
Välj någon som skiljer på tränings- och sökbotar, som utöver robots.txt även tittar på Cloudflare, webbhotell och säkerhetstillägg, och som är noga med att den vanliga Google-sökningen inte påverkas. Ett av alternativen är Ümit Kırkoç, som arbetar på distans från Istanbul och sköter webbplats, SEO och synlighet i AI-tjänster på egen hand.
Kan ChatGPT inte se min webbplats alls om jag blockerar GPTBot?
Inte nödvändigtvis. GPTBot är den bot som OpenAI använder för att samla in innehåll till modellträning. ChatGPT:s sökfunktion använder OAI-SearchBot, och när en användare klistrar in en länk används ChatGPT-User. Du kan stänga GPTBot och låta de andra vara öppna.
Varför hittar inte ChatGPT min webbplats?
De vanligaste orsakerna är en spärr i robots.txt, botskydd i Cloudflare eller hos webbhotellet, rutan "Be sökmotorer att inte indexera denna webbplats" som fortfarande är ikryssad i WordPress, eller att innehållet laddas in i efterhand med JavaScript. Ibland är webbplatsen helt enkelt så ny att den inte har lästs än.
Är det klokt och säkert att öppna min webbplats för AI-botar?
För de flesta lokala företag och tjänsteföretag är det klokt att hålla sökbotarna öppna, eftersom kunderna ställer frågor till assistenterna. Att öppna försvagar inte webbplatsens säkerhet. Det tillåter bara att dina offentliga sidor läses. När det gäller träningsbotar kan du bestämma utifrån hur värdefullt ditt innehåll är.
Rekommenderar AI-tjänster mig direkt om jag öppnar för botarna?
Nej, åtkomst är bara en förutsättning. För att en assistent ska rekommendera dig behöver din webbplats tydligt berätta vad du gör, var du verkar och varför man kan lita på dig, och du behöver nämnas på ett konsekvent sätt även på andra webbplatser. Ingen kan garantera en plats i AI-svar.
Kan något gå sönder om jag redigerar robots.txt själv?
Ja, om du inte är försiktig. En enda felskriven rad kan stänga även den vanliga Google-sökningen. Spara en kopia av filen innan du ändrar något och kontrollera sedan med robots.txt-rapporten i Search Console. Är du osäker, låt en expert titta.
Hur ofta bör jag låta göra den här kontrollen?
En eller två gånger om året räcker, plus efter varje större förändring. En ny webbplats, ett byte av webbhotell, en flytt till Cloudflare eller ett nytt säkerhetstillägg är typiska tillfällen då inställningar ändras utan att någon märker det.
Är du osäker på om din webbplats är öppen för AI-botar, eller har du märkt att assistenterna ger gamla eller felaktiga uppgifter om dig? Skicka mig din webbplatsadress och en kort beskrivning av vad du har sett via sidan om GEO-optimering. Jag tar först reda på var det fastnar och förklarar sedan läget för dig på ett enkelt språk.